Was ist llms.txt? Format, Beispiele und wer die Datei liest
Was llms.txt ist: eine Markdown-Datei im Stammverzeichnis Ihrer Website, die Sprachmodellen eine kuratierte Übersicht Ihrer wichtigsten Seiten gibt. Das Format mit kommentiertem Beispiel, llms-full.txt, der Unterschied zu robots.txt und sitemap.xml und wer die Datei tatsächlich liest.
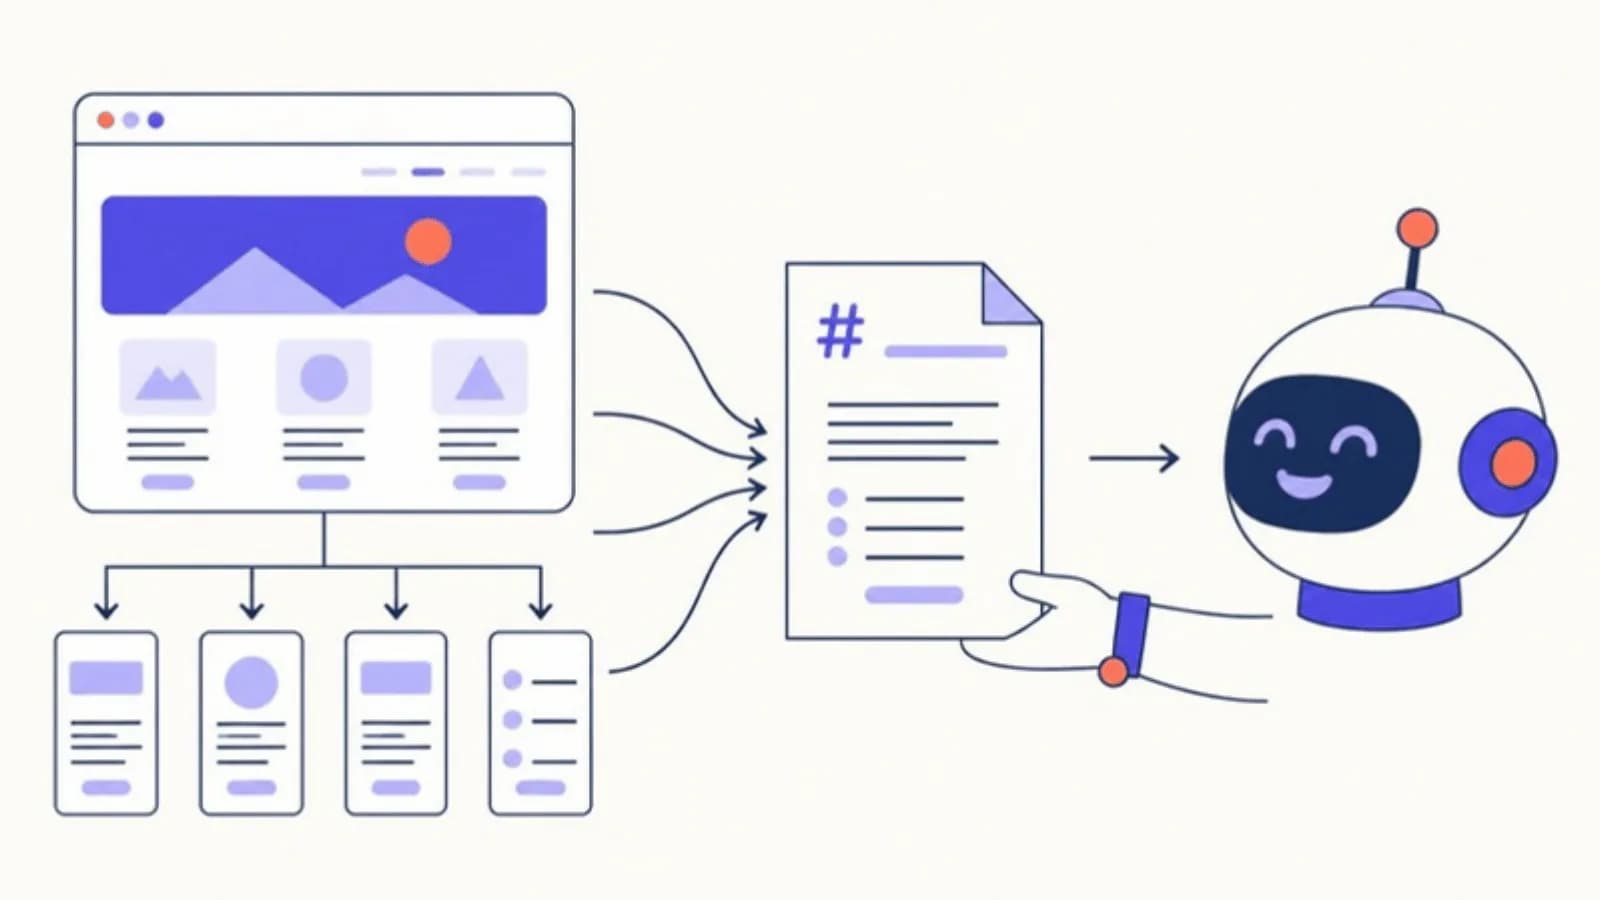
llms.txt ist eine Markdown-Datei im Stammverzeichnis Ihrer Website (yourdomain.com/llms.txt), die Sprachmodellen eine kuratierte Übersicht Ihrer wichtigsten Seiten gibt: eine H1 mit dem Namen der Website, eine einzeilige Zusammenfassung als Blockzitat, danach Abschnitte mit Links. Jeremy Howard von Answer.AI hat das Format im September 2024 vorgeschlagen [1] [2]. Es ist ein Hinweis, keine Zugriffskontrolle, und es ist freiwillig.
- Google sagt, dass die Google Suche, einschliesslich der KI-Funktionen, llms.txt nicht verwendet und dass eine solche Datei Ihrer Sichtbarkeit weder schadet noch nützt [3].
- Kein grosses KI-Unternehmen hat erklärt, das Format offiziell zu unterstützen [2].
- Googles Lighthouse 13.3 hat in seiner neuen Kategorie Agentic Browsing eine llms.txt-Prüfung ergänzt, einen Bereitschaftscheck für Browser-Agenten und kein Suchsignal [4].
- Sinnvoll, wenn die Pflege wenig kostet; Zitierungen sollten Sie davon nicht erwarten.
Wenn Sie in letzter Zeit ein Website-Audit durchgeführt haben, ist die Wahrscheinlichkeit hoch, dass ein Tool „llms.txt fehlt“ gemeldet hat und ein anderes gar nichts. Beide haben auf ihre Weise recht. Die Datei ist ein Vorschlag, kein Standard, und die Lücke zwischen dem, was sie verspricht, und dem, was bestätigt ist, ist so gross, dass es sich lohnt, genau zu wissen, was sie leistet, bevor Sie einen Nachmittag darauf verwenden.
Was llms.txt ist und woher die Datei kommt
Der Vorschlag auf llmstxt.org, den Jeremy Howard am 3. September 2024 veröffentlicht hat, beschreibt sie als Möglichkeit, „die Verwendung einer /llms.txt-Datei zu standardisieren, um Informationen bereitzustellen, die Agenten bei der Nutzung einer Website helfen“ [1]. Howard ist bei Answer.AI tätig, und der Vorschlag wird üblicherweise als seiner in dieser Funktion beschrieben [2].
Das Problem, das sie löst, ist praktischer Natur. Ein Sprachmodell, das eine Webseite öffnet, bekommt zusammen mit dem Inhalt auch Navigation, Cookie-Banner, Skripte und Layout, und es hat nur begrenzten Kontext zur Verfügung. Eine kurze, handverlesene Liste der relevanten Seiten mit einem Satz zu jeder ist leichter zu nutzen als ein Crawl der gesamten Website. Mehr ist llms.txt nicht: ein kuratiertes Inhaltsverzeichnis in Markdown unter einer vorhersehbaren Adresse.
Zwei Punkte werden oft missverstanden. Erstens ist sie keine reine Textliste von URLs: Die Spezifikation definiert eine Markdown-Struktur mit Überschriften, einem Blockzitat und Linklisten [1]. Zweitens erlaubt oder blockiert sie nichts. Über den Zugriff entscheiden weiterhin die robots.txt und Ihr Server; llms.txt schlägt nur vor, wo man nachsehen sollte.
Das Format, mit kommentiertem Beispiel
Die Spezifikation verlangt diese Bestandteile in dieser Reihenfolge [1]:
- Eine H1 mit dem Namen der Website oder des Projekts. Das ist der einzige Pflichtabschnitt.
- Ein Blockzitat mit einer kurzen Zusammenfassung, die ein oder zwei Sätze, die ein Modell vor allem anderen wissen sollte.
- Optionale Details: Absätze oder Listen, aber keine Überschriften, für Kontext wie etwa Hinweise zum Lesen der restlichen Datei.
- Durch H2-Überschriften getrennte Abschnitte, jeweils eine Liste von Markdown-Links im Format
[name](url), optional gefolgt von einem Doppelpunkt und einer Notiz zum Inhalt der Seite. - Ein Abschnitt „Optional“, per Konvention, für zweitrangige Seiten, die ein Modell überspringen kann, wenn der Kontext knapp wird.
So sieht das für einen fiktiven Kaffee-Onlineshop aus:
# Example Coffee Supply

> Specialty coffee beans, grinders and brewing gear, roasted in small batches and sold online in the US.

Prices on the linked pages are in USD and include current stock.

## Shop

- [Coffee beans](https://example.com/collections/coffee): single origins and blends, with roast dates
- [Grinders](https://example.com/collections/grinders): burr grinders for espresso and filter

## Policies

- [Shipping](https://example.com/policies/shipping): delivery times and costs
- [Returns](https://example.com/policies/returns): how returns and refunds work

## Optional

- [Brewing guides](https://example.com/blog): how-to articles by brew method
Von oben gelesen: Die H1 nennt den Shop; das Blockzitat ist die Zusammenfassung, die ein Modell zitieren kann; die einfache Zeile darunter ergänzt Kontext ohne Überschrift; jede H2 gruppiert Links nach Zweck; jeder Link trägt eine kurze Notiz, damit das Modell wählen kann, ohne jede Seite zu öffnen; und der Abschnitt Optional markiert, was wegfallen darf. Die Datei liegt standardmässig im Stammverzeichnis, die aktuelle Spezifikation erlaubt aber auch eine Datei in einem Unterpfad, etwa /docs/llms.txt, die nur die Seiten darunter abdeckt [1].
Die Spezifikation schlägt ausserdem vor, eine saubere Markdown-Version wichtiger Seiten unter derselben URL mit angehängtem .md bereitzustellen, etwa page.html.md [1]. Nur wenige Onlineshops tun das, und für die Funktion der Datei selbst ist es nicht nötig.
Was llms-full.txt ist
llms-full.txt ist eine Begleitdatei, die den vollständigen Text der Dokumentation einer Website in einer einzigen Markdown-Datei bündelt, sodass sich über eine URL der komplette Kontext in ein KI-Tool laden lässt. Sie ist nicht Teil des Vorschlags auf llmstxt.org: Mintlify gibt an, das Format in Zusammenarbeit mit seinem Kunden Anthropic entwickelt zu haben [2]. Sinnvoll ist sie für Software-Dokumentation, die Entwickler in Coding-Assistenten einfügen. Für einen Onlineshop oder eine Dienstleistungswebsite lohnt sich der Umfang selten.
llms.txt vs. robots.txt vs. sitemap.xml
Die drei Dateien liegen im Stammverzeichnis einer Website und werden leicht verwechselt. Sie erfüllen unterschiedliche Aufgaben.
| llms.txt | robots.txt | sitemap.xml | |
|---|---|---|---|
| Was sie tut | Schlägt die Seiten vor, die ein Sprachmodell zuerst lesen sollte, mit einer Notiz zu jeder | Sagt Crawlern, welche Pfade sie abrufen dürfen | Listet die URLs auf, die Suchmaschinen kennen sollen |
| Format | Markdown | Regeln in Klartext (User-agent, Allow, Disallow) | XML |
| Status | Ein Vorschlag vom September 2024 | Ein IETF-Standard, RFC 9309, seit September 2022 [5] | Ein offenes XML-Protokoll [6] |
| Steuert den Zugriff? | Nein | Sie formuliert Regeln, die aber „keine Form der Zugangsautorisierung“ sind [5] | Nein |
| Wer sie liest | Von keiner grossen Engine bestätigt | Such- und KI-Crawler, die den Standard respektieren | Suchmaschinen, als Hinweis, ohne Garantie auf Aufnahme [6] |
| Auswahl | Kuratiert: eine Handvoll wichtiger Seiten | Regeln nach Pfad | Idealerweise jede indexierbare URL |
Wenn Sie nur für eine der drei Zeit haben: Die robots.txt entscheidet, ob eine KI-Engine Ihre Seiten überhaupt lesen und zitieren kann. Der Leitfaden zu KI-Crawlern, robots.txt und llms.txt zeigt, welche Bots Sie zulassen sollten und welche Sie blockieren können.
Wer sie tatsächlich liest
An dieser Stelle werden die meisten Artikel über llms.txt vage, deshalb hier, was mit Stand Oktober 2026 belegt ist.
Google Suche: nein. Googles Leitfaden zu seinen generativen KI-Funktionen sagt, dass Sie keine KI-Textdateien brauchen, um in der Google Suche zu erscheinen, „da die Google Suche selbst sie nicht verwendet“, und dass eine solche Datei Ihrer Sichtbarkeit und Ihren Rankings weder schadet noch nützt [3]. Wie Search Engine Journal festhält, ist llms.txt damit weder für die Google KI-Übersichten (AI Overviews) noch für den KI-Modus (AI Mode) oder die anderen generativen KI-Funktionen der Google Suche nötig [4].
Googles Lighthouse: prüft, ob die Datei vorhanden ist. Lighthouse 13.3 hat die Kategorie Agentic Browsing mit einer llms.txt-Prüfung eingeführt, die kontrolliert, ob die Datei ausgeliefert wird, und Serverfehler meldet; ein 404 wird als „Not Applicable“ (nicht anwendbar) markiert [4]. Das ist ein Bereitschaftscheck für Browser-Agenten, kein Beleg dafür, dass eine Such- oder Antwortmaschine die Datei nutzt. Search Engine Journal hat den Widerspruch in seiner Überschrift zusammengefasst: Googles Empfehlung hängt davon ab, welches Produkt man fragt [4].
OpenAI, Anthropic, Perplexity und die anderen Antwortmaschinen: keine Bestätigung. Keiner dieser Anbieter hat erklärt, dass seine Crawler llms.txt nutzen, um auszuwählen, was sie lesen oder zitieren. Mintlify, das für seine Kunden llms.txt-Dateien generiert und für das Format wirbt, räumt ein, dass kein grosses KI-Unternehmen es offiziell unterstützt [2]. Mintlify verweist zudem auf Daten von Profound, die zeigen, dass KI-Agenten /llms.txt- und /llms-full.txt-Dateien abrufen [2], doch ein Abruf im Serverlog zeigt nur, dass etwas die Datei geholt hat, nicht, dass eine Antwort sie verwendet hat.
Menschen und ihre Tools: manchmal. Der deutlichste Anwendungsfall ist heute ein Entwickler, der die llms.txt oder llms-full.txt einer Dokumentationswebsite in einen Coding-Assistenten einfügt. Der Assistent liest sie, weil ein Mensch sie ihm gegeben hat, so wie er jede andere Seite lesen würde.
Lohnt sich llms.txt?
Das hängt davon ab, was sie Sie kostet. Was ehrlicherweise dafür spricht:
- Sie ist günstig. Eine statische Markdown-Datei mit ein paar Dutzend Links oder eine, die ein Plugin erzeugt.
- Sie birgt wenig Risiko. Google sagt, dass sie in der Suche weder nützt noch schadet [3], und nichts deutet darauf hin, dass sie anderswo schadet.
- Sie ist eine nützliche Übung. Wer entscheidet, welche zwanzig Seiten das eigene Unternehmen repräsentieren, und zu jeder einen Satz schreibt, merkt oft, welche wichtigen Seiten dünn, veraltet oder schwer erreichbar sind.
Was dagegen spricht, mehr als eine Stunde darauf zu verwenden: Keine Engine hat erklärt, die Datei zu lesen, also wird sie Ihnen allein keine Zitierung bringen. Damit eine Seite zitiert wird, muss der Crawler der Engine zugelassen sein, die Seite muss die Frage in Text beantworten, den ein Modell lesen kann, und andere Websites müssen bestätigen, was sie sagt. Fehlen diese drei Dinge, ändert llms.txt nichts; sind sie vorhanden, ist sie eine kleine Ergänzung. So behandeln wir sie auch in der Answer Engine Optimization: ein Nice-to-have nach Zugriff und Inhalten, nie eine Priorität.
Eine praktische Warnung: Eine veraltete Datei ist schlechter als gar keine. Wenn die Datei Produkte auflistet, die Sie nicht mehr verkaufen, oder Seiten, die inzwischen weiterleiten, lassen Sie sie entweder automatisch erzeugen oder aktualisieren Sie sie im selben Rhythmus wie Ihre Sitemap.
So erstellen Sie eine llms.txt
Es gibt drei Wege, je nach Website.
- Einen Generator nutzen. Der kostenlose llms.txt-Generator scannt Ihre Startseite und Ihre Sitemap und erstellt die Datei aus echten URLs Ihrer Website. Prüfen Sie die Liste, kürzen Sie sie auf die relevanten Seiten und laden Sie sie ins Stammverzeichnis hoch, sodass sie unter
yourdomain.com/llms.txterreichbar ist. - Unter WordPress das Plugin arbeiten lassen. Das CiteProof-Plugin erzeugt die llms.txt aus Ihren Inhalten, aktualisiert sie täglich und liefert sie aus, ohne dass eine Datei auf dem Server liegen muss. Siehe so installieren Sie das WordPress-Plugin.
- Von Hand schreiben. Kopieren Sie das Beispiel oben, ersetzen Sie Namen und Zusammenfassung und fügen Sie pro Seitentyp einen H2-Abschnitt hinzu. Halten Sie die Notizen sachlich: was die Seite enthält, nicht warum sie grossartig ist.
Welchen Weg Sie auch wählen: Öffnen Sie die URL danach im Browser und prüfen Sie, ob sie die Datei zurückgibt und nicht einen 404-Fehler oder die Fehlerseite Ihres Themes.
Häufige Fragen
Wofür wird llms.txt verwendet?
Sie gibt Sprachmodellen und KI-Agenten eine kurze, kuratierte Liste der wichtigsten Seiten einer Website mit einer einzeiligen Notiz zu jeder, damit sie die nützlichen Inhalte finden, ohne alles zu crawlen. Sie ist ein Vorschlag, was gelesen werden sollte, keine Regel darüber, was gelesen werden darf.
Liest ChatGPT llms.txt?
OpenAI hat nicht erklärt, dass ChatGPT oder seine Crawler llms.txt verwenden, und kein grosses KI-Unternehmen unterstützt das Format offiziell [2]. Ob ChatGPT eine Seite zitieren kann, hängt davon ab, ob OAI-SearchBot und ChatGPT-User in der robots.txt zugelassen sind und ob die Seite die Frage beantwortet.
Ist llms.txt dasselbe wie robots.txt?
Nein. Die robots.txt ist ein standardisierter Satz von Regeln, der Crawlern sagt, welche Pfade sie abrufen dürfen [5]. llms.txt ist eine Markdown-Liste empfohlener Seiten; sie erlaubt und blockiert nichts. Eine in der robots.txt blockierte Seite bleibt blockiert, egal was in der llms.txt steht.
Brauche ich llms.txt für SEO?
Nein. Google sagt, dass die Google Suche, einschliesslich ihrer KI-Funktionen, llms.txt nicht verwendet und dass eine solche Datei Ihren Rankings weder nützt noch schadet [3]. Sie können eine für andere Dienste veröffentlichen, aber sie ist kein SEO-Faktor.
Wie erstelle ich eine llms.txt-Datei?
Schreiben Sie eine Markdown-Datei mit einer H1 für den Namen der Website, einer Zusammenfassung als Blockzitat und H2-Abschnitten mit Links, und laden Sie sie ins Stammverzeichnis Ihrer Website hoch. Der kostenlose llms.txt-Generator erstellt einen Entwurf aus Ihren echten URLs, und unter WordPress erzeugt und aktualisiert das CiteProof-Plugin die Datei für Sie.
Quellen
- [1] The /llms.txt file · Jeremy Howard, llmstxt.org · September 2024 (aktualisiert August 2026) · abgerufen am 2026-10-14
- [2] What is llms.txt? Breaking down the skepticism · Mintlify · März 2026 · abgerufen am 2026-10-14
- [3] Google's Guide to Optimizing for Generative AI Features on Google Search · Google Search Central · 2026 · abgerufen am 2026-10-14
- [4] Google's llms.txt Guidance Depends On Which Product You Ask · Search Engine Journal · Mai 2026 · abgerufen am 2026-10-14
- [5] RFC 9309: Robots Exclusion Protocol · IETF · September 2022 · abgerufen am 2026-10-14
- [6] Sitemaps XML format · sitemaps.org · 2016 · abgerufen am 2026-10-14
Weiterlesen
CiteProof verfolgt die Sichtbarkeit Ihrer Marke in KI-Antwortmaschinen und sagt Ihnen, was Sie ändern müssen, um zitiert zu werden. Mit einer Regel: Der Score steigt erst, wenn der Verify Bot bestätigt, dass die Korrektur wirklich live ist.